Richard Cornelius Suwandi: Kernel Autoresearch for Open-Ended Model Discovery
Richard Cornelius Suwandi: Autorecherche de noyau pour la découverte de modèles ouverts
Mots-clés
Résumé
200 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur principale réside dans la proposition d’un cadre qui concilie expressivité des programmes libres et garanties mathématiques de validité des noyaux. L’argumentation est solide : elle part d’un exemple illustratif pour montrer le problème des biais inductifs, passe en revue les travaux antérieurs (grammaires de noyaux, spectre mélange, noyaux profonds) pour en souligner les limites, puis détaille la solution avec des justifications théoriques (indécidabilité, preuve par construction). L’évaluation est soignée : utilisation de métriques comme le CRPS pour mesurer toute la distribution prédictive, et protocole de méta-évolution avec phases d’entraînement, validation et test sur des données non vues. Les expériences comparent favorablement la méthode à des baselines établies, et la possibilité d’amélioration par un expert renforce la crédibilité.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est manifeste : l’exposé cite les travaux fondateurs (Duvenaud et al., 2013 ; Wilson & Adams, 2013 ; Wilson et al., 2016 ; FunSearch de DeepMind) et intègre des références à des résultats de la littérature. Les preuves de validité sont construits sur des propriétés mathématiques connues, et les expériences incluent des tests de robustesse sur différentes dimensions et échelles. L’adéquation titre-contenu est parfaite : le titre annonce l’auto-recherche de noyaux pour une découverte ouverte, et la présentation développe exactement cela. Aucun commentaire public n’est disponible pour analyser les tendances d’audience.
228 mots
Adéquation titre / contenu
Le titre reflète précisément le contenu : la présentation décrit une méthode de recherche automatique de noyaux via des agents de codage, visant une découverte de modèles ouverte et transférable.
Qualité & fiabilité
8/10
Présentation d'une recherche originale avec méthodologie détaillée, validation expérimentale sur plusieurs familles de tâches et comparaison à des baselines établies. Les preuves de validité sont construites de façon logique, mais les résultats restent à confirmer par publication et reproduction indépendante.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction et résumé : agents de codage pour découvrir des biais inductifs réutilisables.
- Exemple motivant sur l'ajustement de fonctions inconnues et le rôle du biais inductif.
- Introduction des fonctions noyau et de leur impact sur les processus gaussiens.
- Revue des méthodes existantes : grammaires de noyaux (Duvenaud et al.) et limitations.
- Approches de noyaux spectraux et deep kernel learning, leurs contraintes.
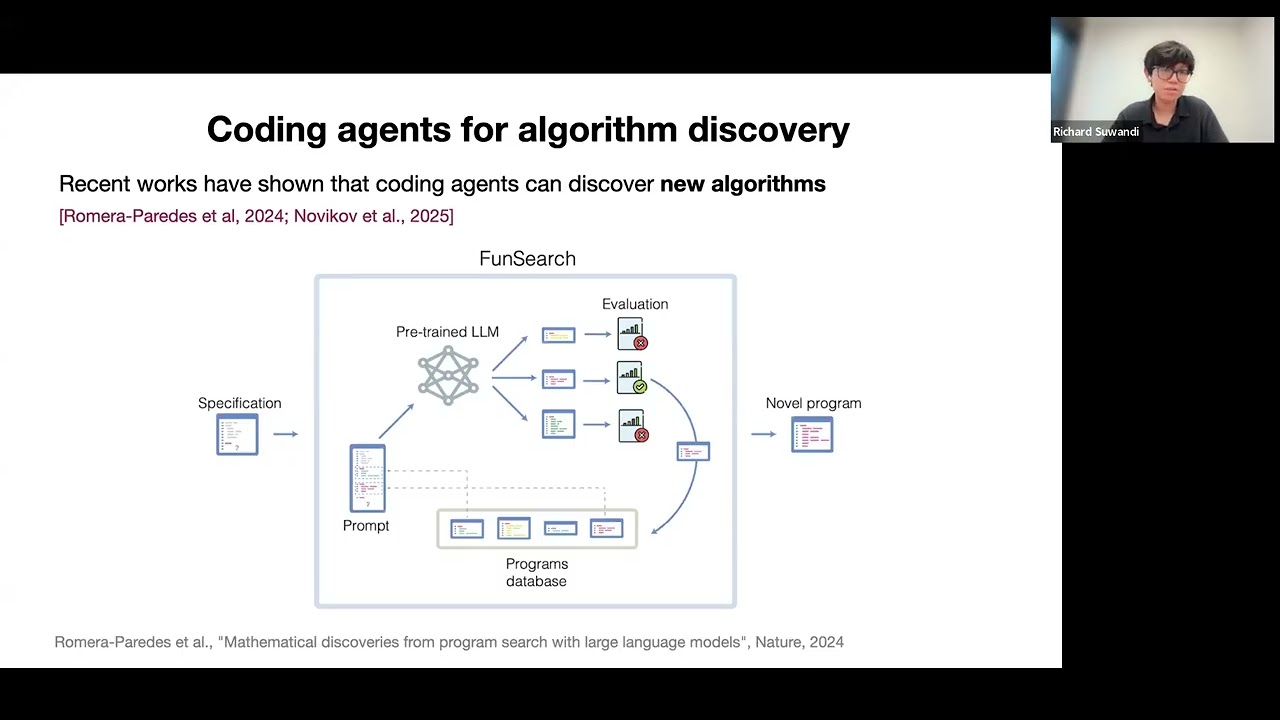
- Inspiration de FunSearch : agents de codage pour découvrir des programmes.
- Présentation de la méthode proposée : répartition des rôles entre l'agent et le backend déterministe.
- Détail des contrats de construction (feature map, spectre, transformation d'entrée, fermeture) et de la vérification à plusieurs niveaux.
- Présentation des résultats expérimentaux : transfert vers des familles non vues et comparaisons avec les baselines.
Sources citées
- Duvenaud et al., 2013 - Expressive Gaussian processes through kernel design — Introduction des grammaires de noyaux et de la recherche par composition.
- Wilson & Adams, 2013 - Spectral Mixture Kernels — Apprentissage de noyaux par mélange spectral dans le domaine fréquentiel.
- Wilson et al., 2016 - Deep Kernel Learning — Combinaison de noyaux spectraux avec des architectures profondes.
- FunSearch (Google DeepMind) — Agents de codage pour découverte d'algorithmes, source d'inspiration.
Sources concordantes
- Travaux sur les noyaux spectraux (Wilson et al.) — Confirment l'importance de l'expressivité des noyaux pour la performance, comme discuté dans l'exposé.
Sources discordantes
- Méthode empirique de validation de noyaux par échantillonnage (concurrente) — L'exposé critique cette approche en montrant que 22-58% des noyaux générés passent les tests empiriques mais échouent sur d'autres échelles ou dimensions, justifiant la nécessité de garanties formelles.
Apport & nouveautés
La contribution principale est de démontrer qu’il est possible de découvrir des noyaux via des programmes générés par LLM tout en garantissant leur validité par construction, grâce à des contrats mathématiques. Cette approche surmonte le dilemme entre grammaire fixe et programmes libres, et introduit un pipeline de méta-évolution avec un archive de qualité-diversité et un filtrage par empreintes pour éviter les redécouvertes. L’originalité réside aussi dans l’application à la découverte de noyaux interprétables transférables à des tâches non vues.
Pour aller plus loin :
- Kernel method (Wikipedia) — Vue d’ensemble des méthodes à noyau et de leur rôle en apprentissage.
- Gaussian process (Wikipedia) — Fondements des processus gaussiens, utilisés pour illustrer l’effet des noyaux.
- Quality diversity (optimisation) — Concepts de qualité-diversité utilisés dans l’archive Map-Elites.
- Novelty search (Wikipedia) — Principe de recherche de nouveauté qui inspire le filtrage par empreintes.
140 mots
Profil radar
Le profil montre un niveau technique très élevé, une qualité d'information supérieure à la quantité, et une fiabilité globale élevée. Cela reflète un contenu dense et rigoureux, adapté à un public d'experts en apprentissage automatique.