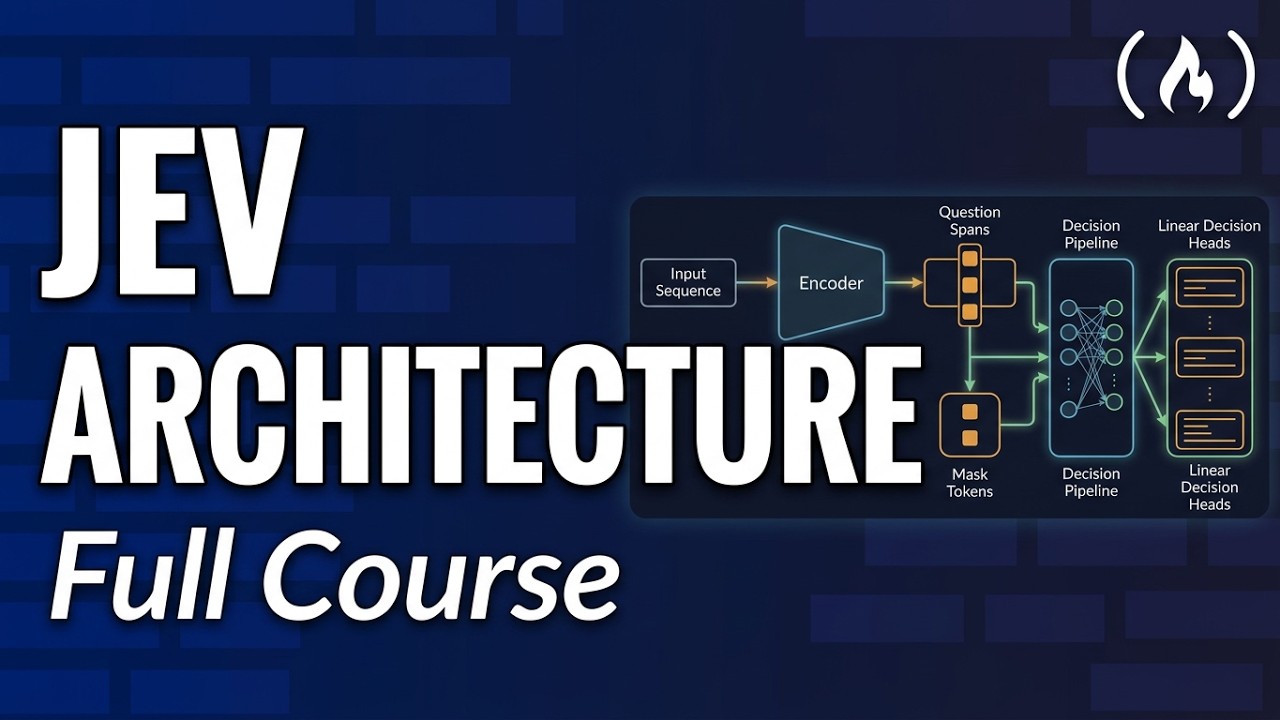
Jev Course – Prefill-Only Inference & Decision Models from Scratch
Cours sur Jev : Inférence "Prefill-Only" et modèles de décision conçus de zéro
Historique des titres
- Jev Course – Prefill-Only Inference & Decision Models from Scratch — observé le 20261027-1319 UTC (YouTube)
Mots-clés
Résumé
137 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur principale réside dans la démonstration pas à pas d’une alternative efficace à la génération autoregressive pour des tâches de décision. L’argumentation est structurée, avec des explications claires sur les mécanismes de KV cache, les différences entre architectures, et les compromis de performance. L’auteur justifie chaque choix technique, comme l’ordre question-contexte pour les modèles encodeurs, et propose des exemples concrets de code. La solidité est renforcée par l’utilisation de modèles pré-entraînés et de frameworks standard, mais l’exposé reste essentiellement pratique, avec relativement peu de références théoriques approfondies.
Rigueur scientifique, qualité des sources, adéquation du titre
Le niveau de rigueur scientifique est bon : les concepts sont présentés avec précision et les implémentations sont reproductibles. Les sources externes mentionnées sont principalement le dépôt GitHub du code (lié au cours) et un ouvrage de l’auteur chez Manning. Le titre est adéquat, même s’il ne précise pas la composante RLCD qui n’est traitée qu’à la fin. La vidéo intègre une mention du sponsor Scrimba dans la description, mais aucune séquence publicitaire distincte n’est identifiée dans le transcript. Dans l’ensemble, la pédagogie et la clarté compensent un manque de références bibliographiques formalisées.
196 mots
Adéquation titre / contenu
Le titre reflète exactement le contenu : un cours sur les modèles de décision pré-remplissage uniquement, avec implémentation de zéro.
Qualité & fiabilité
8/10
Contenu technique approfondi et structuré, présenté par un auteur expérimenté. Toutefois, les références externes restent limitées et les concepts avancés ne sont pas sourcés précisément.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction à Jev et distinction pré-remplissage/décodage
- Explication des interfaces : choix, score, booléen
- Présentation de la feuille de route en 3 phases
- Détail du mécanisme de KV cache et des boucles autoregressives
- Architecture encodeur pour décisions rapides
- Implémentation PyTorch du modèle encodeur Jev
- Masquage causal personnalisé pour le packing multi-questions
- Implémentation du décodeur Jev avec réutilisation du KV cache
- Workflows d'entraînement et distillation enseignant-élève
- Utilisation de GRPO et de trajectoires perturbées
Sources citées
- Dépôt GitHub du cours (code source) — Code complet et exemples du cours
- Vivek Kalyanarangan, Quantization and Fast Inference (Manning) — Ouvrage de l'auteur mentionné comme référence complémentaire
- freeCodeCamp News (articles sur la programmation) — Article de référence cité dans la description
- freeCodeCamp (site principal) — Organisation et plateforme d'apprentissage
Références externes
Apport & nouveautés
Ce cours apporte une pédagogie pratique pour implémenter Jev, une alternative récente aux LLM génératifs pour des tâches de décision. Il détaille les architectures encoder et decoder, le mécanisme de KV cache réutilisable et les techniques d’entraînement comme le RLCD. La démonstration pas à pas avec PyTorch rend le concept accessible à un public initié.
Pour aller plus loin :
- Dépôt GitHub du cours — Source principale d’implémentation, à consulter pour reproduire les exemples.
- Vivek Kalyanarangan, Quantization and Fast Inference (Manning) — Référence complémentaire sur l’optimisation et l’inférence rapide des modèles.
- Concepts d’attention et de KV cache — Expliqués dans la vidéo, ils sont fondamentaux pour comprendre Jev. Une introduction plus générale se trouve dans l’article Wikipédia sur l’attention (sans URL vérifiée, mentionnée par nom).
125 mots
Profil radar
Le profil radar montre un très bon contenu en quantité et en niveau technique, mais une fiabilité en retrait en raison d'un manque de citations formelles. La qualité globale est néanmoins élevée, indiquant une vidéo solide pour un public spécialisé.